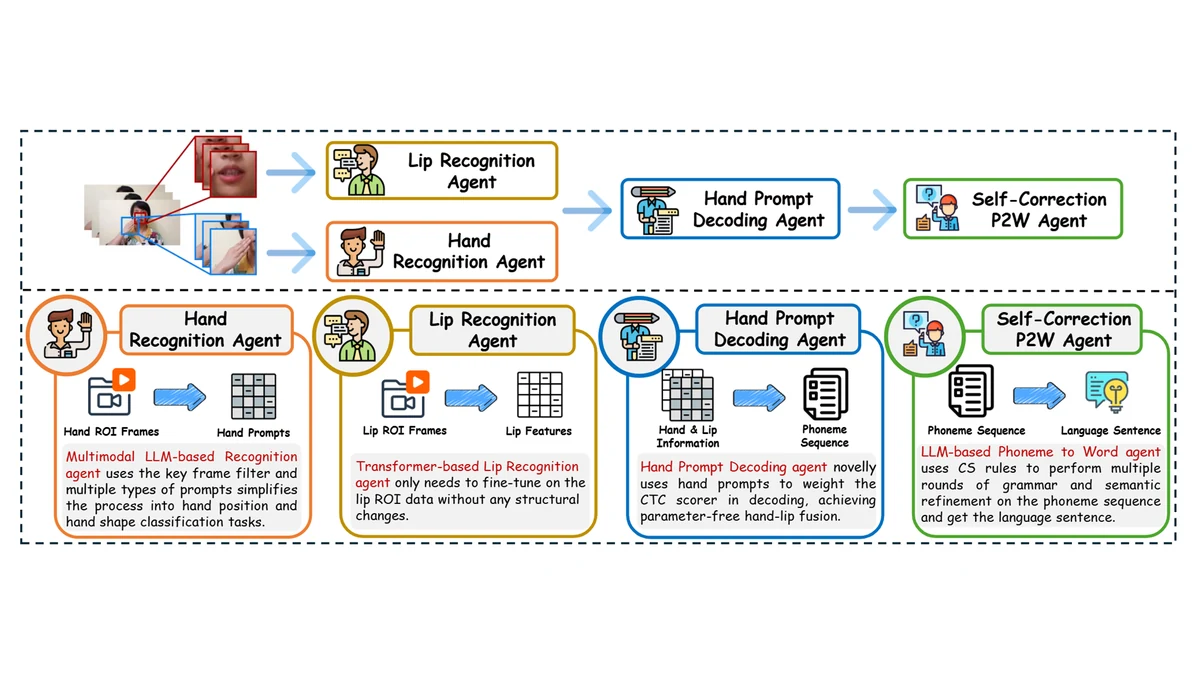
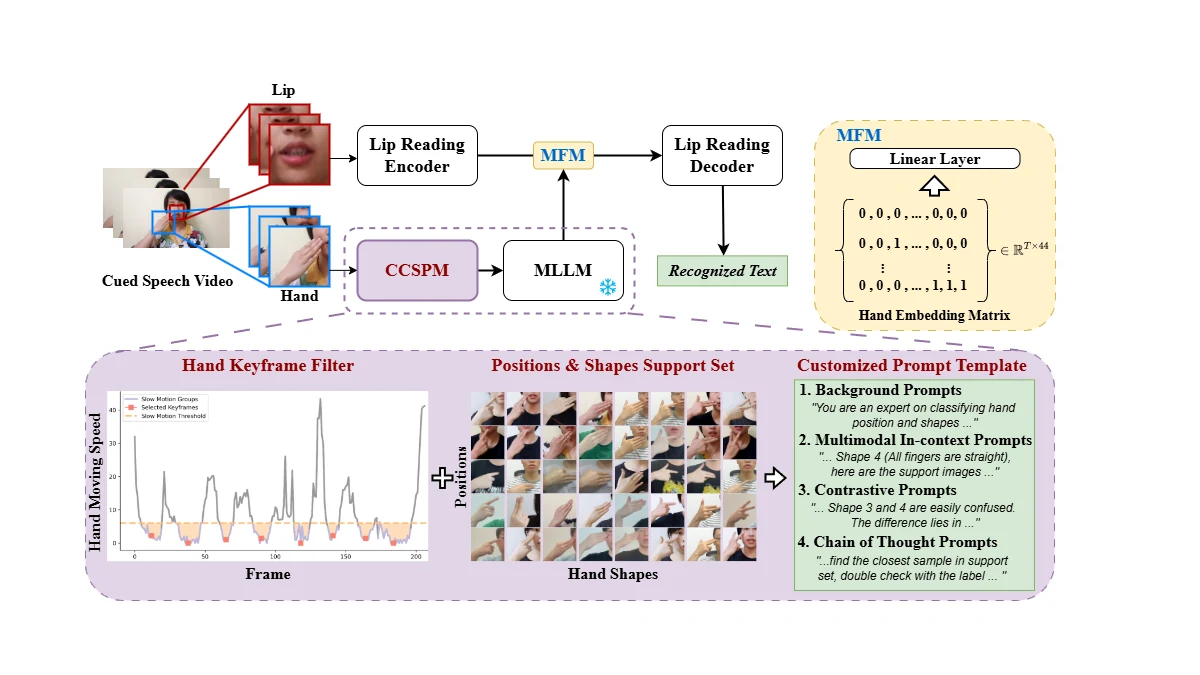
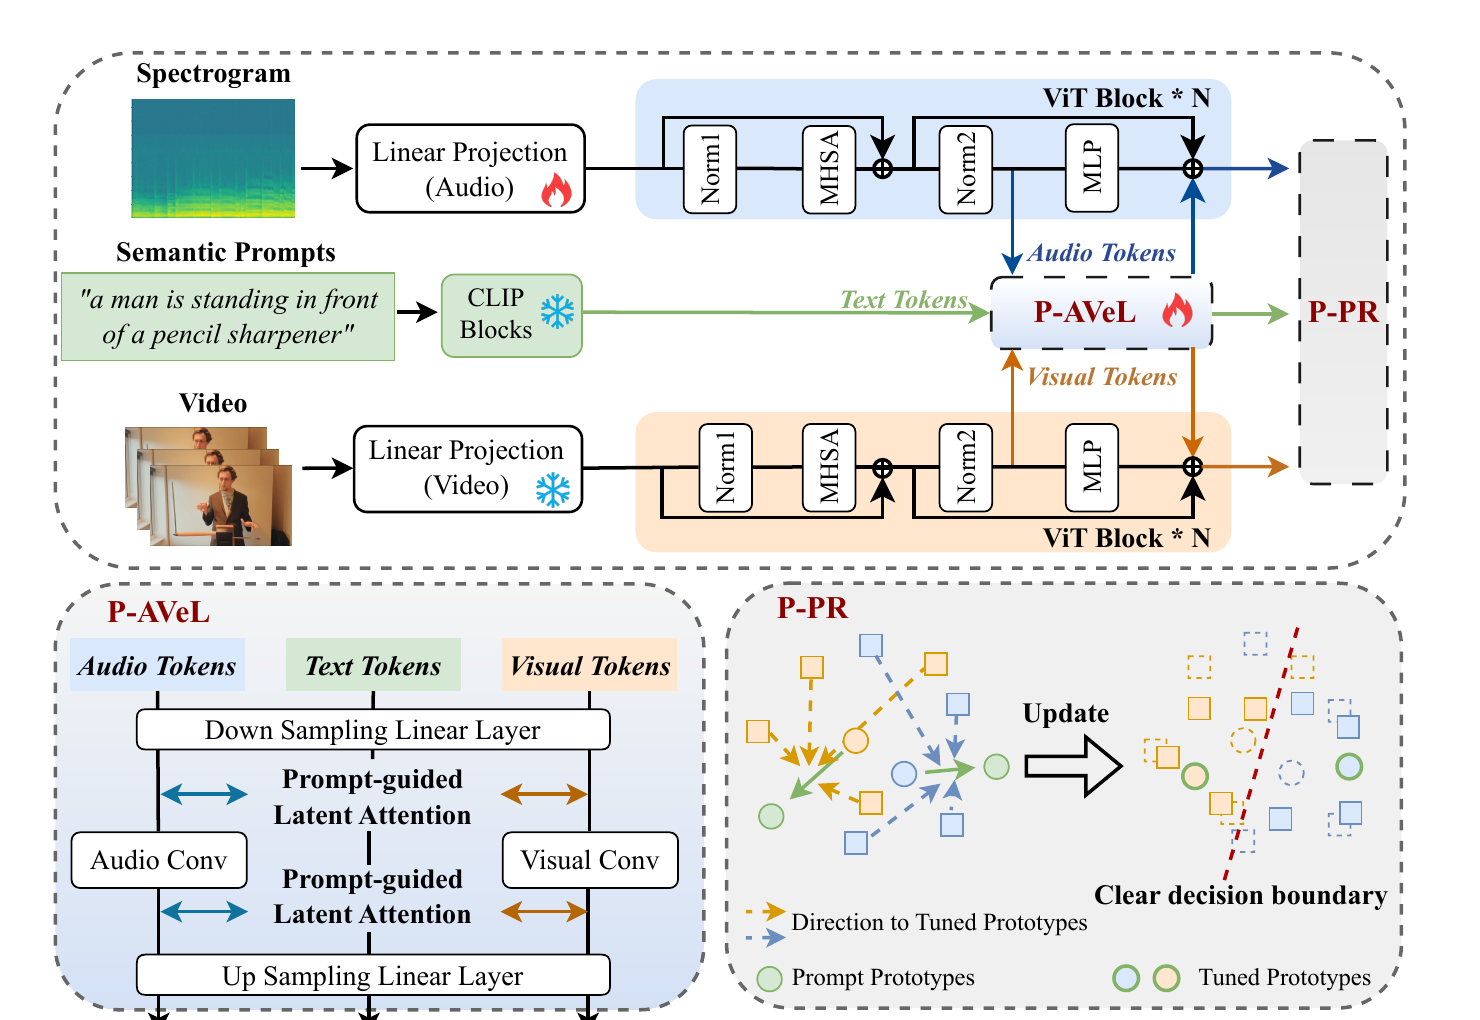
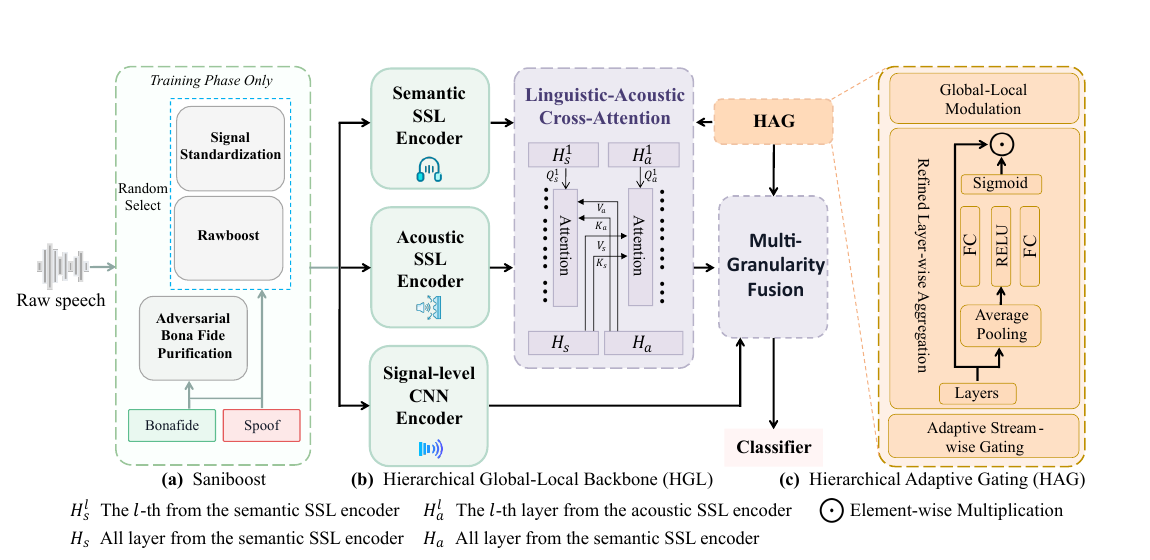
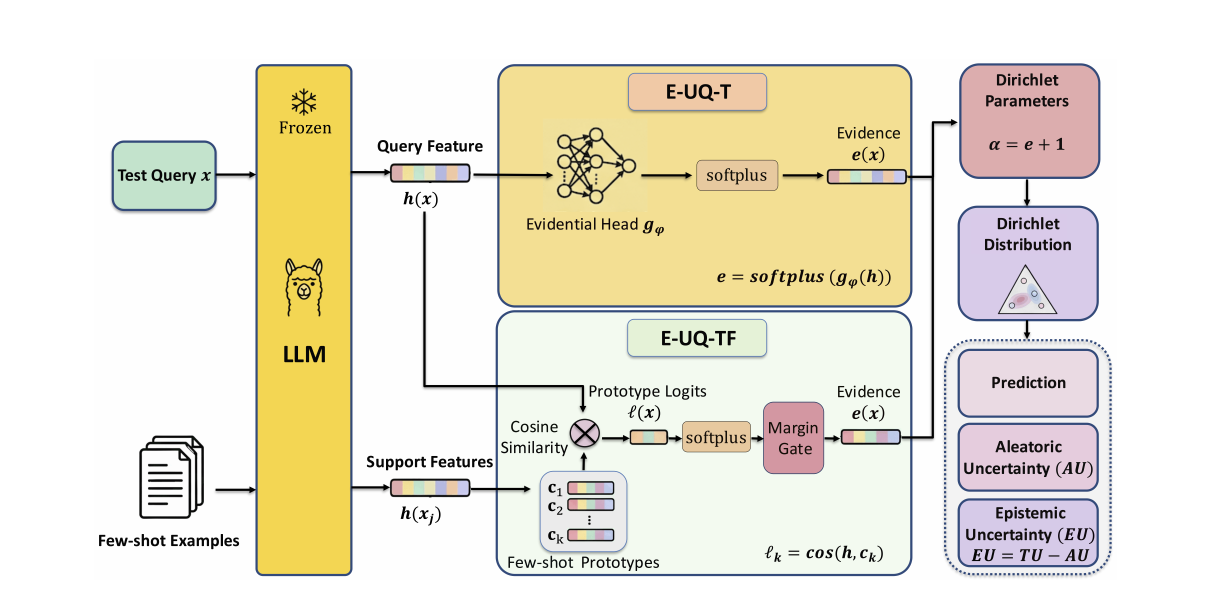
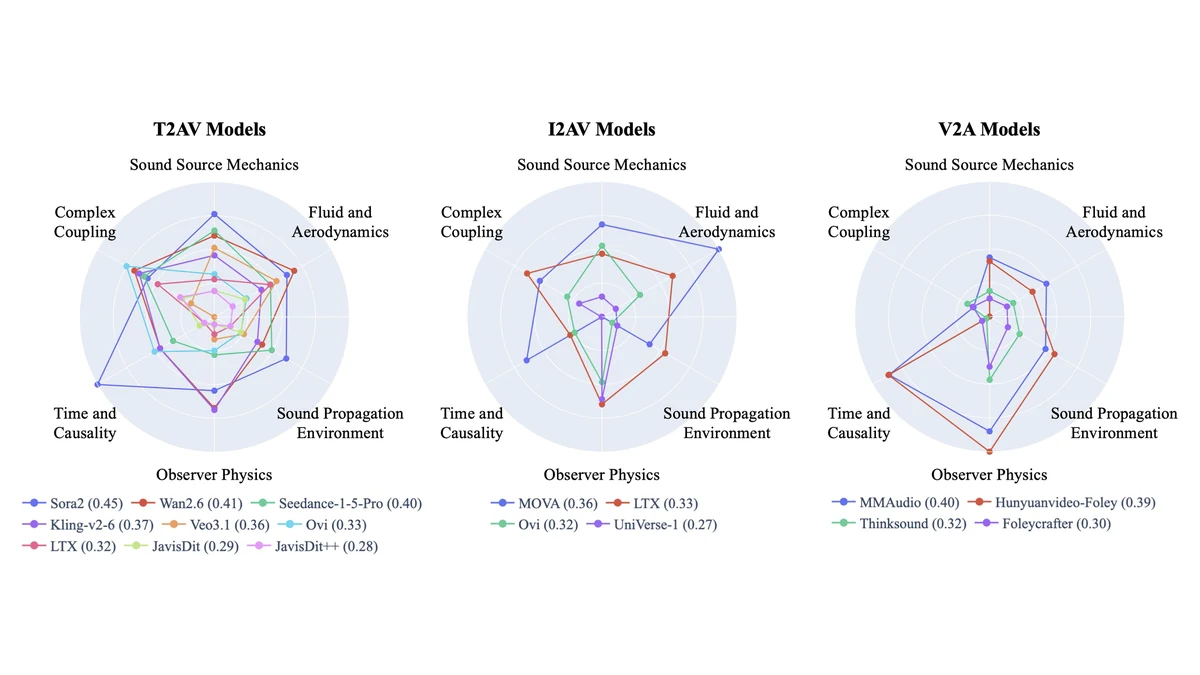
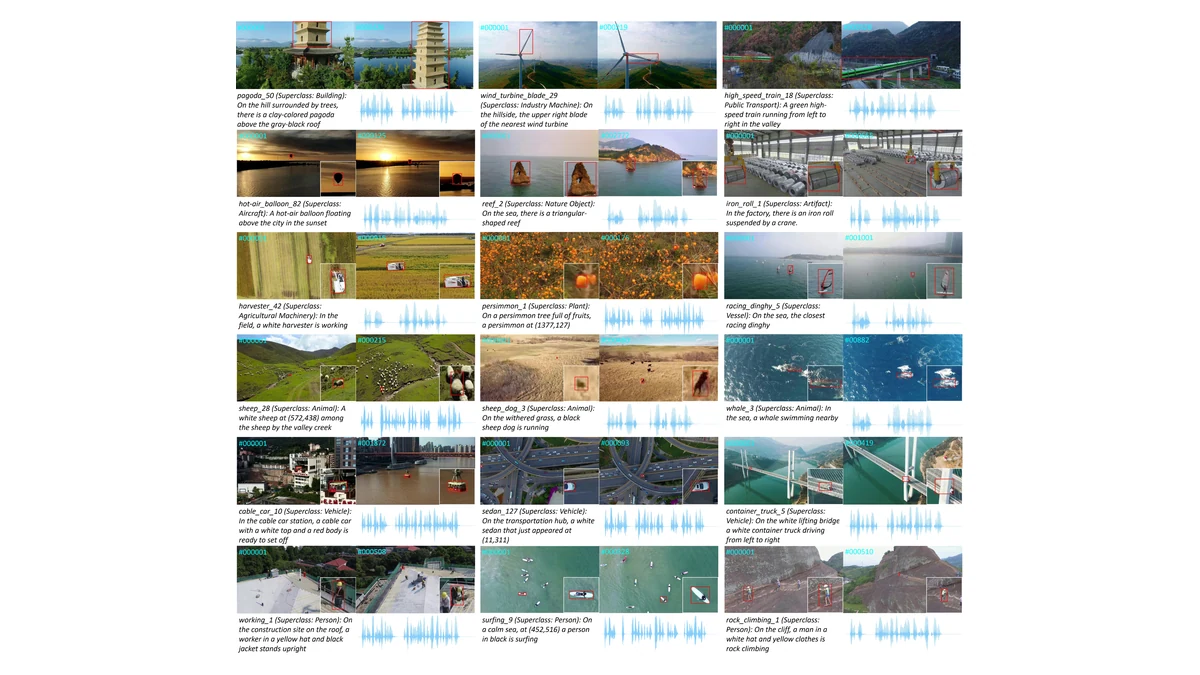
研究 Cued-Agent 四个专用智能体协同完成手势识别、唇读、手唇融合与语言级自校正,无需端到端训练整个系统。 STF-ACSR 用多模态大模型免训练识别关键手势,再以单层线性映射将手势提示注入预训练唇读模型。 Semantic Modulated Prompting 以语义提示缓解小样本音视频学习中的过拟合、时序异步与模态失衡,并保持参数高效。 GLAD 音频伪造检测 结合全局-局部自监督表征、样本级自适应门控与 SaniBoost,提升未知攻击及跨域检测能力。 上下文学习的证据不确定性 以单次前向传播完成查询级不确定性估计,减少对提示和重复生成的依赖并显著降低 Token 成本。 评测基准 PhyAVBench 通过只改变单一声学物理变量的成对提示,评估生成音频是否作出符合物理规律的响应。 WebUAV-3M 包含 330 万帧、4500 个视频和 223 类目标,并加入自然语言规范与音频描述的无人机跟踪基准。