STF-ACSR
基于多模态大模型手势建模的半免训练自动线索语识别。
STF-ACSR 将连续手部建模转化为多模态大模型的零样本分类任务,再用极简融合把识别到的手势提示注入预训练唇读模型,降低小数据场景中的过拟合风险。
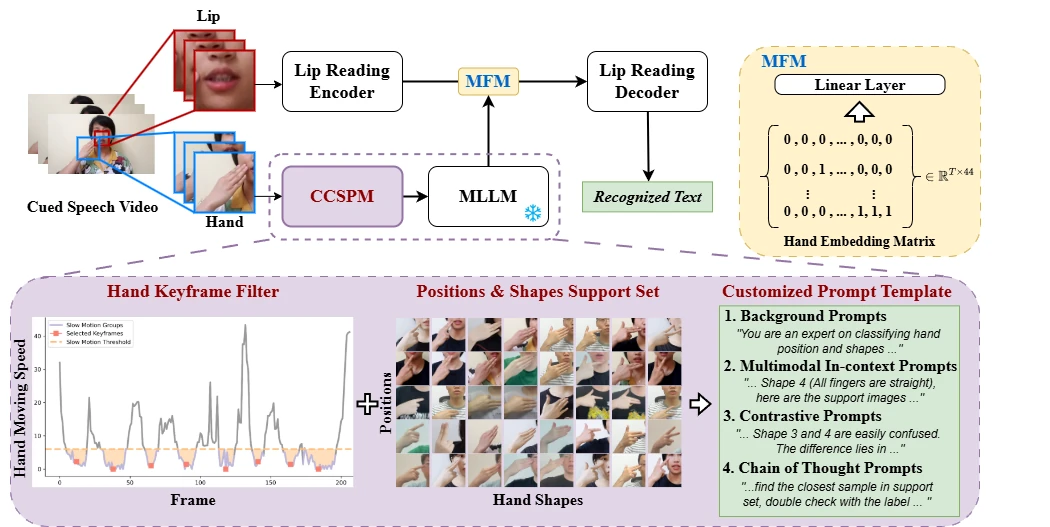
原论文与项目仓库中的 STF-ACSR 框架图。
核心亮点
- 免训练手势提示: 根据手部运动速度自动筛选关键帧,并通过背景、多模态上下文、对比和推理提示激活多模态大模型的手势识别能力。
- 极简跨模态融合: 将手势识别结果编码为嵌入矩阵,仅用一个线性层完成对齐,再以特征相加方式提示唇读模型。
- 面向低资源场景: 避免训练复杂手部时序模型与大型融合网络,在保留手势与唇部互补信息的同时减少任务专用参数。