上下文学习的证据不确定性
面向高效可靠大模型推理的查询级证据不确定性估计。
该项目针对固定标签上下文学习中的不确定性估计容易受提示措辞和示例采样影响、且常依赖重复生成的问题,提出查询级证据不确定性框架 E-UQ。
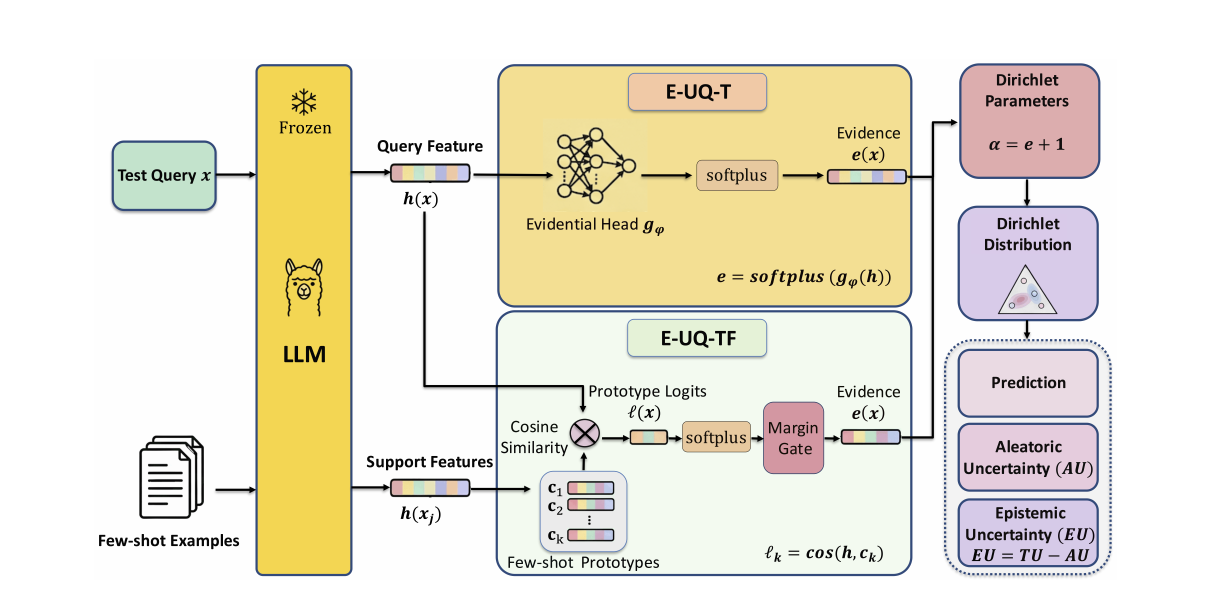
原稿 Figure 3:E-UQ-T 学习轻量证据头,E-UQ-TF 构建少样本类别原型;二者均输出狄利克雷分布,用于预测及不确定性分解。
核心亮点
- 查询级单次前向: 冻结大语言模型,仅提取测试查询的隐藏表示并映射为类别概率上的狄利克雷分布,同时获得预测、数据不确定性与模型不确定性。
- 两种使用模式: E-UQ-T 训练轻量证据头;E-UQ-TF 用少量样本构建类别原型,可在不训练大模型的情况下工作。
- 可靠性与效率并重: 在五个自然语言分类数据集和多个 LLaMA、Qwen 模型上评估误分类检测、提示扰动稳定性及分布外检测;评估设置中平均输入 Token 成本降低约 96.7%。